Vous avez certainement déjà copié-collé vos notes de réunion dans ChatGPT pour créer des comptes rendus. Mais quand vous avez des tâches récurrentes qui reviennent chaque semaine, et pour plusieurs collaborateurs, il peut être utile d'avoir un outil dédié.
Avoir son propre outil comporte plusieurs avantages :
-
un prompt écrit une seule fois pour des comptes rendus structurés de manière homogène
-
pas de copier-coller, le résultat peut être enregistré ou envoyé par mail
-
le choix du modèle avec un paiement à l'usage
Nous allons développer un petit outil internet pour l'entreprise de Patrick : Boréal Systèmes. Patrick colle ses notes et le compte rendu s'écrit en direct sous ses yeux.
Nous utiliserons FastAPI, qui gère nativement le streaming depuis la version 0.135.0 sortie en mars 2026, PydanticAI et l'API d'OpenAI.
C'est quoi le streaming d'un LLM ?
Un LLM ne produit pas une réponse en un bloc, il va la générer au fur et à mesure, token par token. Un token correspond à un petit morceau de texte, mais n'hésitez pas à aller lire notre glossaire sur CarnetIA.
Sans streaming, le serveur attend le dernier token avant de tout envoyer, alors qu'avec le streaming, chaque morceau est transmis au navigateur au fur et à mesure qu'il est prêt.
Ça ne veut pas dire que la réponse complète arrive plus vite, mais pour vos utilisateurs, c'est bien mieux d'afficher la réponse token par token : le temps paraît passer plus vite.
SSE, WebSocket ou JSON Lines : quel format choisir ?
Le format le plus courant est le Server-Sent Events (SSE). Il s'agit d'une requête HTTP dont la connexion reste ouverte et dans laquelle le serveur envoie des en-têtes (dont Content-Type: text/event-stream) et des blocs de texte, séparés par une ligne vide :
event: token
data: " Patrick"

event: token
data: " valide"
Chaque bloc est nommé avec un contenu. Il s'agit d'un format standardisé que les navigateurs lisent nativement via EventSource.
Ici, le WebSocket n'aurait pas d'intérêt, car il ouvre un canal dans les deux sens. Nous n'avons besoin que d'un seul.
Le JSON Lines envoie un objet JSON par ligne :
{"type":"token","texte":"Réunion"}
{"type":"token","texte":" du"}
FastAPI n'ajoute ni ping pour garder la connexion ouverte, ni en-têtes pour les proxys. Ces en-têtes permettent de demander à Nginx de transmettre chaque morceau quand il arrive.
Conclusion : on part sur du Server-Sent Events.
Préparation du projet
Je pense que si vous avez regardé les derniers guides sur Docstring, vous connaissez bien uv. C'est ce que je vais utiliser sur ce projet pour les dépendances.
uv init --no-package compte-rendu-stream
cd compte-rendu-stream
uv add "fastapi[standard]" "pydantic-ai-slim[openai]"
uv add --dev pytest
-
fastapi[standard]permet d'installer FastAPI, sa commandefastapi devethttpx -
pydantic-ai-slim[openai]installe Pydantic AI avec juste ce qu'il faut pour OpenAI, on évite d'embarquer tous les fournisseurs -
pytestnous servira pour... les tests 😛. Nous avons un article sur cette librairie
Récupérez votre clé API sur la plateforme d'OpenAI et placez-la dans un fichier .env à la racine :
OPENAI_API_KEY=sk-.............
Nous ferons comme dans l'article sur la transcription audio : nous chargerons le fichier .env avec l'option --env-file.
Pour le guide, on utilise gpt-6-luna, le million de tokens est à 0,10 $ / 0,50 $, et il est suffisant pour des comptes rendus.
Comment streamer une réponse avec FastAPI ?
Déjà, sans brancher de LLM, prenons une liste de mots envoyés un par un.
Avant FastAPI 0.135.0
Avant la version 0.135.0 de FastAPI, il fallait passer par StreamingResponse et écrire son propre format SSE. Créez un fichier ancienne_methode.py :
import asyncio
import json
from collections.abc import AsyncIterator

from fastapi import FastAPI
from fastapi.responses import StreamingResponse

app = FastAPI()

MOTS = ["Réunion", " du", " lundi", " :", " Patrick", " présente", " le", " budget."]


async def generer_evenements() -> AsyncIterator[str]:
    for mot in MOTS:
        await asyncio.sleep(0.3)
        # Le format SSE est à écrire à la main, sans oublier la ligne vide finale
        yield f"event: token\ndata: {json.dumps(mot)}\n\n"
    yield "event: done\ndata: [DONE]\n\n"


@app.get("/demo")
async def demo() -> StreamingResponse:
    return StreamingResponse(
        generer_evenements(),
        media_type="text/event-stream",
        # Des en-têtes à ne pas oublier... et à connaître
        headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"},
    )
asyncio.sleep() sert uniquement à simuler le temps de génération d'un LLM.
Vous pouvez maintenant lancer le serveur pour tester :
uv run fastapi dev ancienne_methode.py
Puis dans un autre terminal, curl permet de voir les évènements :
curl -N http://127.0.0.1:8000/demo
Passons maintenant aux choses sérieuses !
Depuis FastAPI 0.135.0
FastAPI gère maintenant le SSE nativement.
Créez le fichier nouvelle_methode.py :
import asyncio
from collections.abc import AsyncIterable

from fastapi import FastAPI
from fastapi.sse import EventSourceResponse, ServerSentEvent

app = FastAPI()

MOTS = ["Réunion", " du", " lundi", " :", " Patrick", " présente", " le", " budget."]


@app.get("/demo", response_class=EventSourceResponse)
async def demo() -> AsyncIterable[ServerSentEvent]:
    for mot in MOTS:
        # On simule le temps de génération d'un LLM
        await asyncio.sleep(0.3)
        yield ServerSentEvent(data=mot, event="token")
    # Un dernier événement pour signaler la fin du flux
    yield ServerSentEvent(raw_data="[DONE]", event="done")
-
response_class=EventSourceResponseindique que la route renvoie du flux SSE -
yieldpour que chaque valeur devienne un évènement envoyé au client -
-> AsyncIterable[ServerSentEvent]est le typage que vous retrouverez dans la documentation -
ServerSentEventpermet de remplir les champs de l'évènement -
dataest encodé en JSON, tandis queraw_dataenvoie le texte tel quel
Et maintenant testons ça !
uv run fastapi dev nouvelle_methode.py
Puis curl avec l'option -i pour afficher les en-têtes :
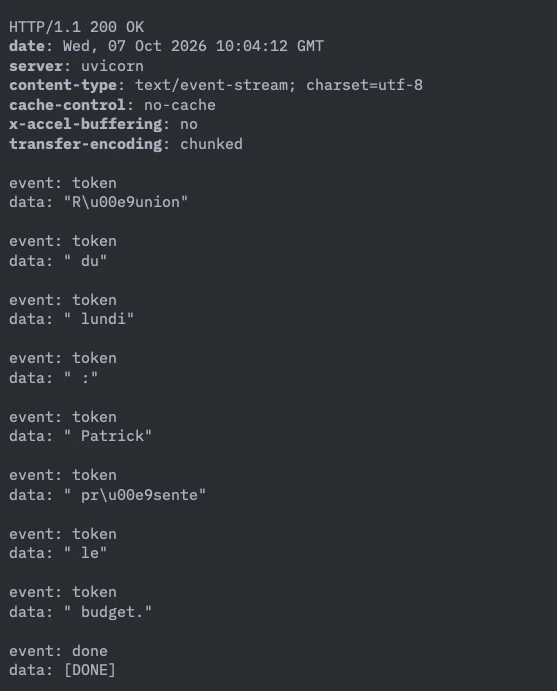
curl -N -i http://127.0.0.1:8000/demo
Aperçu
Les en-têtes cache-control et x-accel-buffering sont là d'office !
Comment streamer la réponse de l'IA avec Pydantic AI ?
Si je ne me trompe pas, ça va faire le troisième article où j'évoque Pydantic AI. Nous avons d'ailleurs un article dédié à cette librairie.
Ce que renvoie OpenAI
Regardons d'abord ce que renvoie l'API d'OpenAI quand on lui demande de streamer :
curl https://api.openai.com/v1/responses \
  -N \
  -H "Authorization: Bearer votre_cle_api" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6-luna", "input": "Dis bonjour à Patrick en une phrase.", "stream": true}'
Voici un extrait de la sortie :
event: response.created
data: {"type":"response.created","response":{"id":"resp_026da9024e7c90a5006ac736dea30487d18781b4a59a24ae2e","object":"response","created_at":1791440606,"status":"in_progress",[...],"model":"gpt-6-luna",[...],"store":true,[...]},"sequence_number":0}

[...]

event: response.output_text.delta
data: {"type":"response.output_text.delta","content_index":0,"delta":"Bonjour",[...],"sequence_number":4}

event: response.output_text.delta
data: {"type":"response.output_text.delta","content_index":0,"delta":" Patrick",[...],"sequence_number":5}

[...]

event: response.output_text.done
data: {"type":"response.output_text.done",[...],"sequence_number":14,"text":"Bonjour Patrick, j’espère que tu vas bien !"}

[...]

event: response.completed
data: {"type":"response.completed","response":{"id":"resp_026da9024e7c90a5006ac736dea30487d18781b4a59a24ae2e","object":"response","created_at":1791440606,"status":"completed",[...],"usage":{"input_tokens":15,"input_tokens_details":{"cache_write_tokens":0,"cached_tokens":0},"output_tokens":14,"output_tokens_details":{"reasoning_tokens":0},"total_tokens":29},"user":null,"metadata":{}},"sequence_number":17}
On retrouve les formats event / data. Les principaux évènements :
-
response.created: OpenAI ouvre la réponse avec un identifiant -
response.output_text.delta: un nouveau morceau de texte. Il s'agit d'une différence, chaque évènement reçu ne contient que ce qui s'est ajouté depuis le précédent -
response.output_text.done: le texte est terminé, et l'évènement le renvoie en entier, il ne nous servira pas -
response.completed: la génération est terminée -
error: 😭
Le SDK d'OpenAI serait suffisant en soi, et on ne garderait que les delta, mais Pydantic AI apporte plusieurs choses :
-
récupérer uniquement les morceaux de texte
-
la consommation de tokens
-
une seule famille d'exceptions à gérer
-
des modèles factices pour les tests
-
changer de fournisseur comme de chemise
Brancher Pydantic AI
Dans main.py :
from collections.abc import AsyncIterable

from fastapi import FastAPI
from fastapi.sse import EventSourceResponse, ServerSentEvent
from pydantic import BaseModel, Field
from pydantic_ai import Agent


MODELE = "openai:gpt-6-luna"

agent = Agent(
    MODELE,
    instructions=(
        "Tu rédiges en français le compte rendu d'une réunion de Boréal Systèmes "
        "à partir des notes brutes d'un collaborateur. "
        "Structure-le en Markdown avec ces sections : Résumé, Décisions, Actions, "
        "Questions ouvertes. N'invente rien : si une information manque, ne la "
        "mentionne pas."
    ),
)

app = FastAPI()


class Notes(BaseModel):
    texte: str = Field(min_length=20, max_length=20_000)


@app.post("/compte-rendu", response_class=EventSourceResponse)
async def compte_rendu(notes: Notes) -> AsyncIterable[ServerSentEvent]:
    async with agent.run_stream(notes.texte) as resultat:
        # debounce_by=None : chaque morceau part dès qu'il arrive
        async for morceau in resultat.stream_text(delta=True, debounce_by=None):
            yield ServerSentEvent(data=morceau, event="token")

    # La consommation n'est complète qu'une fois le flux terminé
    usage = resultat.usage
    yield ServerSentEvent(
        data={
            "tokens_entree": usage.input_tokens,
            "tokens_sortie": usage.output_tokens,
            "cout_dollars": usage.cost,
        },
        event="usage",
    )
    yield ServerSentEvent(raw_data="[DONE]", event="done")
-
le préfixe
openai:indique à Pydantic AI de passer par l'API Responses d'OpenAI -
le modèle
Notespermet de valider le corps de la requête -
agent.run_stream()lance la génération en streaming -
stream_text(delta=True)renvoie uniquement les nouveaux morceaux et non le texte complet accumulé -
resultat.usageindique le nombre de tokens etusage.costrenvoie une estimation si Pydantic AI connaît les prix, sinonNone
Lancez le serveur :
uv run --env-file .env fastapi dev main.py
Testons maintenant avec curl :
curl -N -X POST http://127.0.0.1:8000/compte-rendu \
  -H "Content-Type: application/json" \
  -d '{"texte": "Réunion lundi avec Patrick et Sébastien : budget de 12k validé, Patrick envoie le détail vendredi."}'
Voici une partie de la réponse :
event: token
data: "##"

event: token
data: " R\u00e9s"

event: token
data: "um\u00e9"

[...]

event: token
data: " notes"

event: token
data: "."

event: usage
data: {"tokens_entree": 98, "tokens_sortie": 162, "cout_dollars": 9.08e-05}

event: done
data: [DONE]
Le compte rendu est bien arrivé morceau par morceau, puis l'évènement usage nous donne la consommation de la requête.
Comment afficher le flux avec Streamlit ?
Patrick n'est pas à l'aise avec curl, donc on va créer une interface avec Streamlit, qui permet de créer une page web en Python !
uv add streamlit
Créez le fichier app_streamlit.py :
import json
from collections.abc import Iterator

import httpx
import streamlit as st

URL = "http://127.0.0.1:8000/compte-rendu"


def lire_evenements(reponse: httpx.Response) -> Iterator[tuple[str, str]]:
    """Découpe le flux SSE en couples (type, données), au fil de l'eau."""
    type_evenement = "message"
    for ligne in reponse.iter_lines():
        if ligne.startswith("event: "):
            type_evenement = ligne.removeprefix("event: ")
        elif ligne.startswith("data: "):
            yield type_evenement, ligne.removeprefix("data: ")
            type_evenement = "message"


def lire_texte(reponse: httpx.Response, infos: dict) -> Iterator[str]:
    """Renvoie le texte morceau par morceau et range la consommation dans infos."""
    for type_evenement, donnees in lire_evenements(reponse):
        if type_evenement == "token":
            yield json.loads(donnees)
        elif type_evenement == "usage":
            infos["usage"] = json.loads(donnees)


st.title("Compte rendu de réunion")
notes = st.text_area("Notes de réunion", height=200)

if st.button("Générer le compte rendu") and notes:
    infos = {}
    # timeout=30 : délai maximal entre deux morceaux reçus
    with httpx.stream("POST", URL, json={"texte": notes}, timeout=30) as reponse:
        if reponse.status_code != 200:
            st.error(f"Erreur {reponse.status_code}")
        else:
            st.write_stream(lire_texte(reponse, infos))

    if "usage" in infos:
        usage = infos["usage"]
        st.caption(
            f"{usage['tokens_entree']} tokens en entrée, "
            f"{usage['tokens_sortie']} en sortie"
        )
-
httpx.stream()envoie la requête et lit la réponse au fur et à mesure -
iter_lines()lit le corps au fur et à mesure qu'il arrive -
lire_evenements()regroupe les lignes en couples -
lire_texte()est un générateur qui renvoie le texte et rangeusagedans le dictionnaireinfos -
st.write_stream()affiche chaque morceau dès qu'il arrive
Lancez l'API :
uv run --env-file .env fastapi dev main.py
Et Streamlit dans un second terminal :
uv run streamlit run app_streamlit.py
Dans la page Streamlit, amusez-vous à coller des notes de réunion, vous verrez que le rendu est sympa niveau expérience utilisateur.
Comment tester un endpoint « IA » sans dépenser de crédits ?
On en parlait dans cet article : Pydantic AI fournit TestModel, un modèle factice pour les tests.
TestModel renvoie une réponse prévisible que l'on peut définir, et on peut remplacer le modèle de l'agent pendant le test.
Créez le fichier test_main.py :
import json

from fastapi.testclient import TestClient
from pydantic_ai import models
from pydantic_ai.models.test import TestModel

from main import agent, app

# Filet de sécurité : aucun appel réel au LLM pendant les tests
models.ALLOW_MODEL_REQUESTS = False

client = TestClient(app)

NOTES = {"texte": "Réunion lundi : Patrick présente le budget 2027."}


def lire_evenements(corps: str) -> list[tuple[str, str]]:
    """Découpe le corps SSE en une liste de couples (type, données)."""
    evenements = []
    for bloc in corps.strip().split("\n\n"):
        lignes = dict(ligne.split(": ", 1) for ligne in bloc.split("\n"))
        evenements.append((lignes.get("event", "message"), lignes.get("data", "")))
    return evenements


def test_le_compte_rendu_arrive_en_plusieurs_morceaux():
    """
    Given un modèle de test qui répond un texte connu
    When on demande un compte rendu
    Then le texte arrive en plusieurs événements token, suivis de usage et done
    """
    texte_attendu = "Patrick présente le budget 2027 de Boréal Systèmes."
    with agent.override(model=TestModel(custom_output_text=texte_attendu)):
        reponse = client.post("/compte-rendu", json=NOTES)

    assert reponse.status_code == 200
    assert reponse.headers["content-type"].startswith("text/event-stream")

    evenements = lire_evenements(reponse.text)
    morceaux = [json.loads(data) for type_, data in evenements if type_ == "token"]
    assert len(morceaux) > 1
    assert "".join(morceaux) == texte_attendu
    assert [type_ for type_, _ in evenements[-2:]] == ["usage", "done"]


def test_des_notes_trop_courtes_sont_refusees():
    """
    Given des notes de moins de 20 caractères
    When on demande un compte rendu
    Then FastAPI répond 422 avant même d'appeler le LLM
    """
    reponse = client.post("/compte-rendu", json={"texte": "trop court"})

    assert reponse.status_code == 422
-
models.ALLOW_MODEL_REQUESTS = Falseest une garde pour empêcher tout test qui tenterait d'appeler un vrai modèle -
le temps du
with, l'agent n'appelle plus OpenAI, il répond avecTestModelqui renvoie toujours le texte découpé mot par mot -
reponse.textcontient tous les évènements etlire_evenements()les découpe comme on le fait avec Streamlit
Lancez les tests en chargeant le .env :
uv run --env-file .env pytest -v
Bien que la clé soit chargée, avec agent.override() et ALLOW_MODEL_REQUESTS, on n'appelle jamais OpenAI 😎.