Construire son outil de transcription audio peut s'avérer très pratique. Car oui, il existe des outils tout faits comme Happy Scribe ou les transcriptions de Google Meet. Mais construire son propre outil a plusieurs avantages :
-
décider ce qui en sort, comme un simple compte rendu, un ticket, un e-mail, ou encore un enregistrement dans la base de données
-
décider de l'endroit où il tourne
-
décider de ce que vous payez : il n'est pas forcément nécessaire d'avoir un abonnement
Nous allons construire une petite application dont le but est d'enregistrer un mémo vocal, puis de récupérer la transcription pour faire un compte rendu structuré avec les décisions de chacun.
Aussi, nous passerons par l'API d'OpenAI pour profiter de la puissance de leurs serveurs. La contrepartie est que votre audio quitte votre machine. Si vous souhaitez utiliser un modèle en local, il faudra en trouver un adapté à votre configuration.
Concernant les modèles utilisés : gpt-transcribe, modèle recommandé par OpenAI pour retranscrire un enregistrement, et gpt-4o-transcribe-diarize pour savoir qui parle. Comme rien n'est gratuit, comptez environ deux centimes pour cinq minutes (avec les prix d'octobre 2026).
Préparation du projet
Pour ma part, j'utilise uv :
uv init --no-package transcription-audio
cd transcription-audio
uv add openai gradio
-
openainous sera utile pour appeler l'API -
gradiopour l'interface web (vous allez voir, c'est incroyable)
Maintenant, la clé API OpenAI, vous pouvez l'obtenir sur leur plateforme et la placer dans un fichier .env à la racine du projet :
OPENAI_API_KEY=sk-.............
À noter
Pensez à ajouter le .env dans le fichier .gitignore si jamais vous versionnez votre projet.
Contrairement à d'habitude (pour ceux qui sont habitués à mes guides), ici pas de python-dotenv ni de os.getenv() pour lire la clé. Il existe une petite astuce avec uv pour charger le .env avec l'option --env-file. Le client OpenAI lit tout seul la variable OPENAI_API_KEY.
On verra ça au moment voulu.
Comment transcrire un fichier audio avec l'API OpenAI ?
Premier test
J'ai enregistré un mémo avec mon Mac dans lequel je dis que je veux préparer une réunion avec Patrick et Sébastien. Je l'ai renommé en memo.m4a, et mis à la racine du projet. Dans main.py :
from pathlib import Path

from openai import OpenAI

# Le client lit la clé dans la variable d'environnement OPENAI_API_KEY
client = OpenAI()

with Path("memo.m4a").open("rb") as fichier_audio:
    transcription = client.audio.transcriptions.create(
        model="gpt-transcribe",
        file=fichier_audio,
    )

print(transcription.text)
print(transcription.languages)
Le fichier est ouvert en mode binaire ("rb") pour l'envoyer à l'API. On affiche le texte et la langue détectée.
Puis je lance le script :
uv run --env-file .env main.py
Et j'ai ma transcription :
Voilà, bon ben je pense qu'il est temps de préparer une réunion avec Patrick et Sébastien.
[TranscriptionLanguage(code='fr')]
À noter
OpenAI indique une limite de 25 Mo par fichier. Si jamais vous avez besoin de compresser des fichiers audio, vous pouvez passer par ffmpeg : ffmpeg -i fichier.wav -ac 1 -b:a 64k fichier.mp3.
Aider le modèle
Parfois, le modèle peut être amené à buter sur du vocabulaire technique ou des noms propres. Nous avons trois paramètres à notre disposition pour l'aider :
-
promptpour du contexte -
keywordsest une liste de mots prononcés dans l'enregistrement, pratique pour du vocabulaire technique ou des noms propres -
languagespour les langues parlées
Maintenant, recommençons :
from pathlib import Path

from openai import OpenAI

client = OpenAI()

with Path("memo.m4a").open("rb") as fichier_audio:
    transcription = client.audio.transcriptions.create(
        model="gpt-transcribe",
        file=fichier_audio,
        # Du contexte libre sur l'enregistrement
        # prompt="Mémo vocal sur le projet intranet de Boréal Systèmes.",
        # Les termes que l'on s'attend à entendre
        # keywords=["Boréal Systèmes", "Wagtail", "HTMX"],
        # Les langues parlées dans l'enregistrement
        languages=["fr"],
    )

print(transcription.text)
Le résultat avec mon audio sans le prompt et les keywords est satisfaisant, il a juste fait une petite erreur sur Boreal System au lieu de Boréal Systèmes.
Donc on va organiser une réunion avec Patrick et Sébastien pour le nouvel outil interne, donc dans notre entreprise Boreal System. Et pour ça, on va utiliser donc Wagtail et HTMX.
Maintenant, avec le prompt et les keywords :
from pathlib import Path

from openai import OpenAI

client = OpenAI()

with Path("memo.m4a").open("rb") as fichier_audio:
    transcription = client.audio.transcriptions.create(
        model="gpt-transcribe",
        file=fichier_audio,
        # Du contexte libre sur l'enregistrement
        prompt="Mémo vocal sur le projet intranet de Boréal Systèmes.",
        # Les termes que l'on s'attend à entendre
        keywords=["Boréal Systèmes", "Wagtail", "HTMX"],
        # Les langues parlées dans l'enregistrement
        languages=["fr"],
    )

print(transcription.text)
L'orthographe est juste :
Donc on va organiser une réunion avec Patrick et Sébastien pour le nouvel outil interne, donc dans notre entreprise Boréal Systèmes. Et pour ça, on va utiliser donc Wagtail et HTMX.
Comment créer une interface de transcription avec Gradio ?
J'ai déjà utilisé Streamlit dans un guide précédent. Pour cette application, je vais changer un peu mes habitudes et utiliser Gradio, framework que j'ai utilisé en mentorat sur Docstring.
Commencez par créer un fichier app.py :
from pathlib import Path

import gradio as gr
from openai import OpenAI

client = OpenAI()


def transcrire(chemin_audio: str | None) -> str:
    """Transcrit l'audio enregistré au micro ou déposé dans l'interface."""
    if chemin_audio is None:
        raise gr.Error("Enregistrez ou déposez un fichier audio.")

    chemin = Path(chemin_audio)

    with chemin.open("rb") as fichier_audio:
        transcription = client.audio.transcriptions.create(
            model="gpt-transcribe",
            file=fichier_audio,
            languages=["fr"],
        )
    return transcription.text


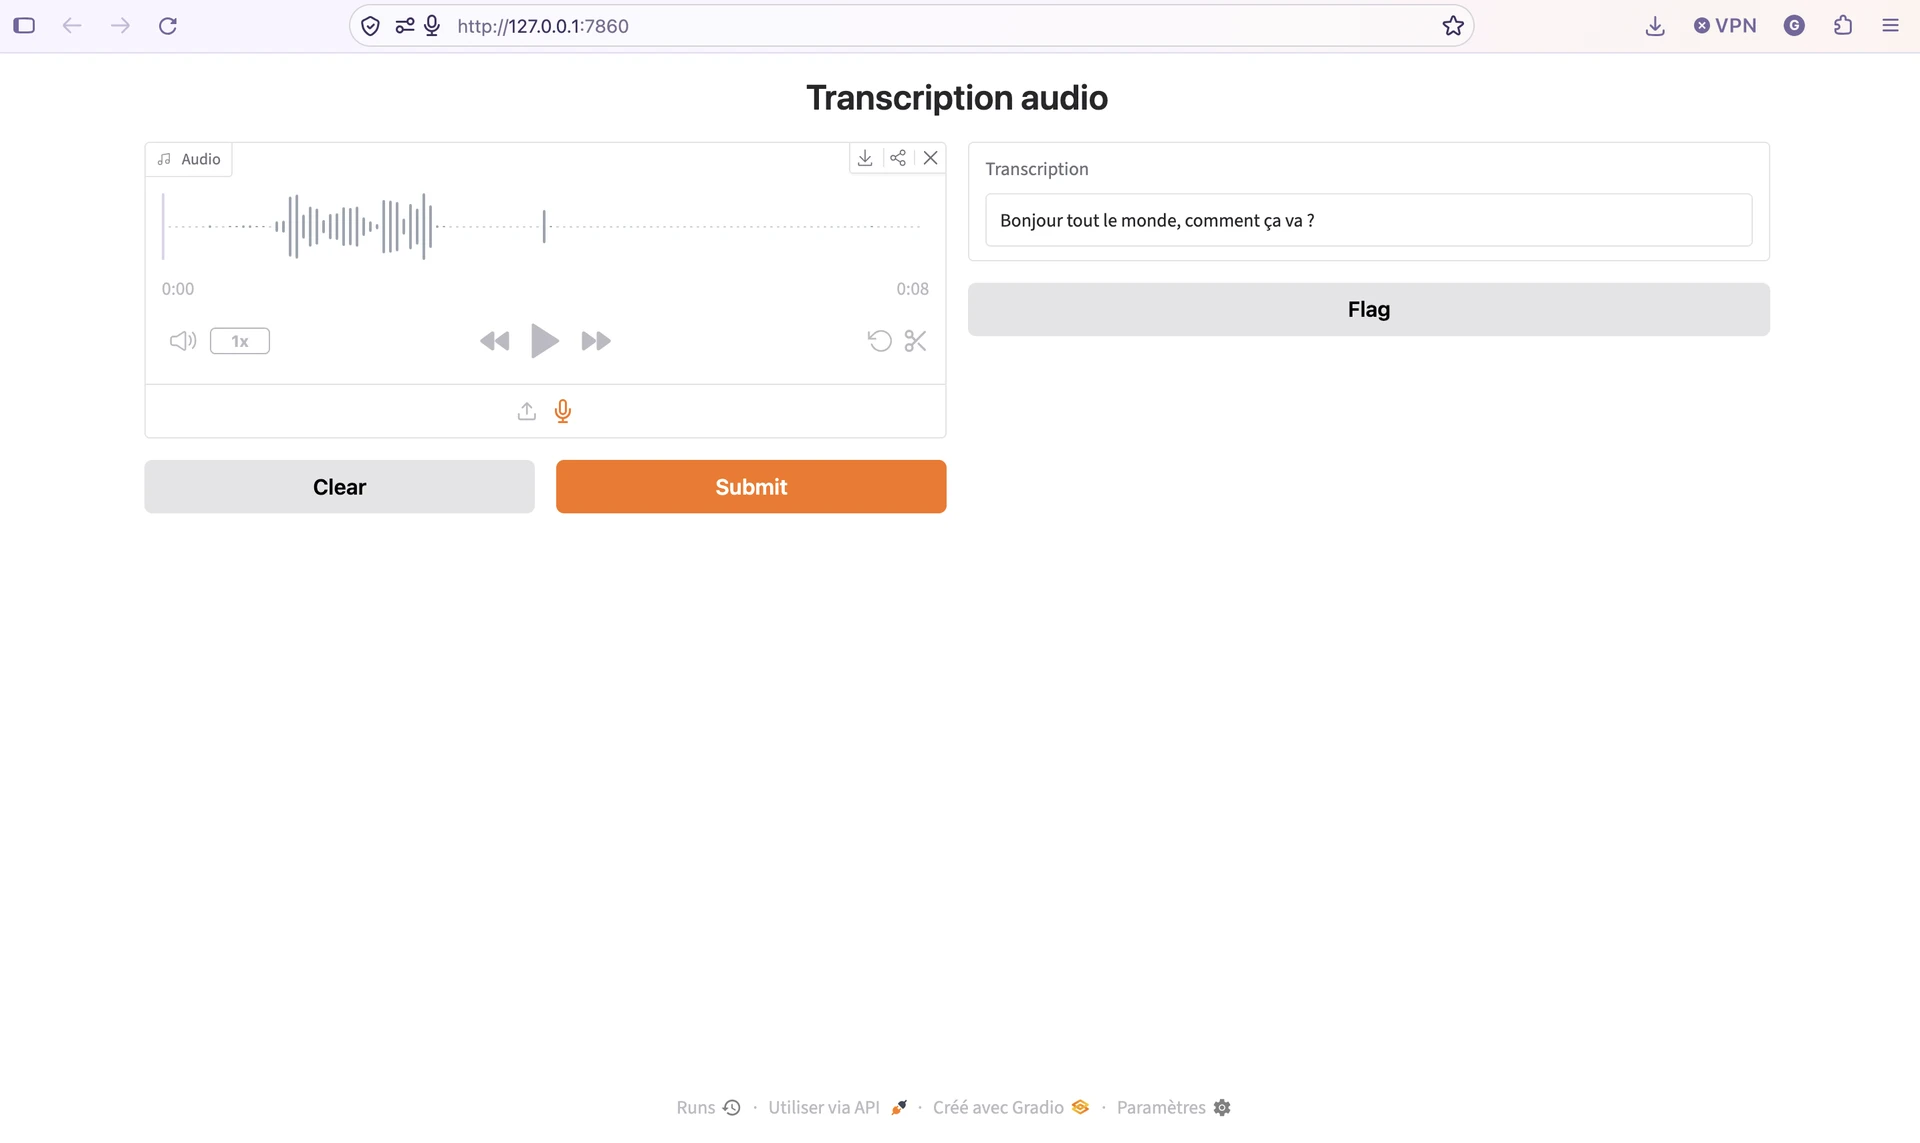
demo = gr.Interface(
    fn=transcrire,
    inputs=gr.Audio(sources=["microphone", "upload"], type="filepath", label="Audio"),
    outputs=gr.Textbox(label="Transcription"),
    title="Transcription audio",
)

if __name__ == "__main__":
    demo.launch()
-
sourcesdéfinit les façons d'obtenir l'audio, et le premier élément de la liste est la source affichée par défaut -
type="filepath"permet d'indiquer à Gradio de passer le chemin d'un fichier temporaire à notre fonction -
gr.Erroraffiche le message d'erreur dans l'interface Gradio
Lancez l'application tout en chargeant le .env :
uv run --env-file .env app.py

# URL : http://127.0.0.1:7860
L'interface
Comment transformer une transcription en compte rendu ?
Maintenant que notre application fonctionne, on va demander à notre modèle d'en tirer un compte rendu.
Pour cela, nous utilisons Pydantic, déjà installé avec le SDK d'OpenAI. Créons le fichier compte_rendu.py :
from pathlib import Path

from openai import OpenAI
from pydantic import BaseModel, Field

# Les noms de modèles changent vite : on range le nôtre dans une constante
MODELE_TEXTE = "gpt-6-luna"

client = OpenAI()


class Action(BaseModel):
    tache: str
    responsable: str | None = Field(
        description="Personne chargée de la tâche, si elle est citée"
    )
    echeance: str | None = Field(
        description="Échéance telle qu'elle a été formulée à l'oral"
    )


class CompteRendu(BaseModel):
    resume: str = Field(description="Résumé en trois phrases maximum")
    decisions: list[str]
    actions: list[Action]
    questions_ouvertes: list[str]


def rediger_compte_rendu(transcription: str) -> CompteRendu:
    """Transforme une transcription brute en compte rendu structuré."""
    reponse = client.responses.parse(
        model=MODELE_TEXTE,
        instructions=(
            "Tu rédiges en français le compte rendu d'une réunion "
            "ou d'un mémo vocal de l'entreprise Boréal Systèmes. "
            "N'invente rien : si une information n'apparaît pas dans la transcription, "
            "laisse le champ vide."
        ),
        input=transcription,
        text_format=CompteRendu,
    )
    if reponse.output_parsed is None:
        raise ValueError("Le modèle n'a pas renvoyé de compte rendu exploitable.")
    return reponse.output_parsed


def en_markdown(compte_rendu: CompteRendu) -> str:
    """Met en forme le compte rendu en Markdown."""
    lignes = ["# Compte rendu", "", compte_rendu.resume]
    if compte_rendu.decisions:
        lignes += ["", "## Décisions", ""]
        lignes += [f"- {decision}" for decision in compte_rendu.decisions]
    if compte_rendu.actions:
        lignes += ["", "## Actions", ""]
        for action in compte_rendu.actions:
            responsable = action.responsable or "à définir"
            echeance = f" (échéance : {action.echeance})" if action.echeance else ""
            lignes.append(f"- {action.tache} → {responsable}{echeance}")
    if compte_rendu.questions_ouvertes:
        lignes += ["", "## Questions ouvertes", ""]
        lignes += [f"- {question}" for question in compte_rendu.questions_ouvertes]
    return "\n".join(lignes) + "\n"


if __name__ == "__main__":
    texte = Path("transcription.txt").read_text(encoding="utf-8")
    compte_rendu = rediger_compte_rendu(texte)
    print(compte_rendu.model_dump_json(indent=2))
    print(en_markdown(compte_rendu))
-
text_format=CompteRenduindique au SDK quel formatJSONgénérer -
les descriptions passées à
Fielddonnent des indications sur ce que doit contenir chaque champ -
str | Noneautorise le champ à être vide ; d'ailleurs, n'hésitez pas à aller lire notre article sur le typage
Pour ma part, je vais utiliser GPT-6 Luna, car il est vraiment très abordable lorsqu'il s'agit de traiter du volume.
Ensuite, on câble le tout dans l'interface app.py :
import tempfile
from pathlib import Path

import gradio as gr
from openai import OpenAI

from compte_rendu import en_markdown, rediger_compte_rendu

client = OpenAI()


def transcrire(chemin_audio: str | None) -> str:
    """Transcrit l'audio enregistré au micro ou déposé dans l'interface."""
    if chemin_audio is None:
        raise gr.Error("Enregistrez ou déposez un fichier audio.")

    chemin = Path(chemin_audio)
    with chemin.open("rb") as fichier_audio:
        transcription = client.audio.transcriptions.create(
            model="gpt-transcribe",
            file=fichier_audio,
            languages=["fr"],
        )
    return transcription.text


def traiter(chemin_audio: str | None) -> tuple[str, str, str]:
    """Transcrit l'audio, rédige le compte rendu et prépare le fichier Markdown."""
    texte = transcrire(chemin_audio)
    markdown = en_markdown(rediger_compte_rendu(texte))
    chemin_md = Path(tempfile.mkdtemp()) / "compte_rendu.md"
    chemin_md.write_text(markdown, encoding="utf-8")
    return texte, markdown, str(chemin_md)


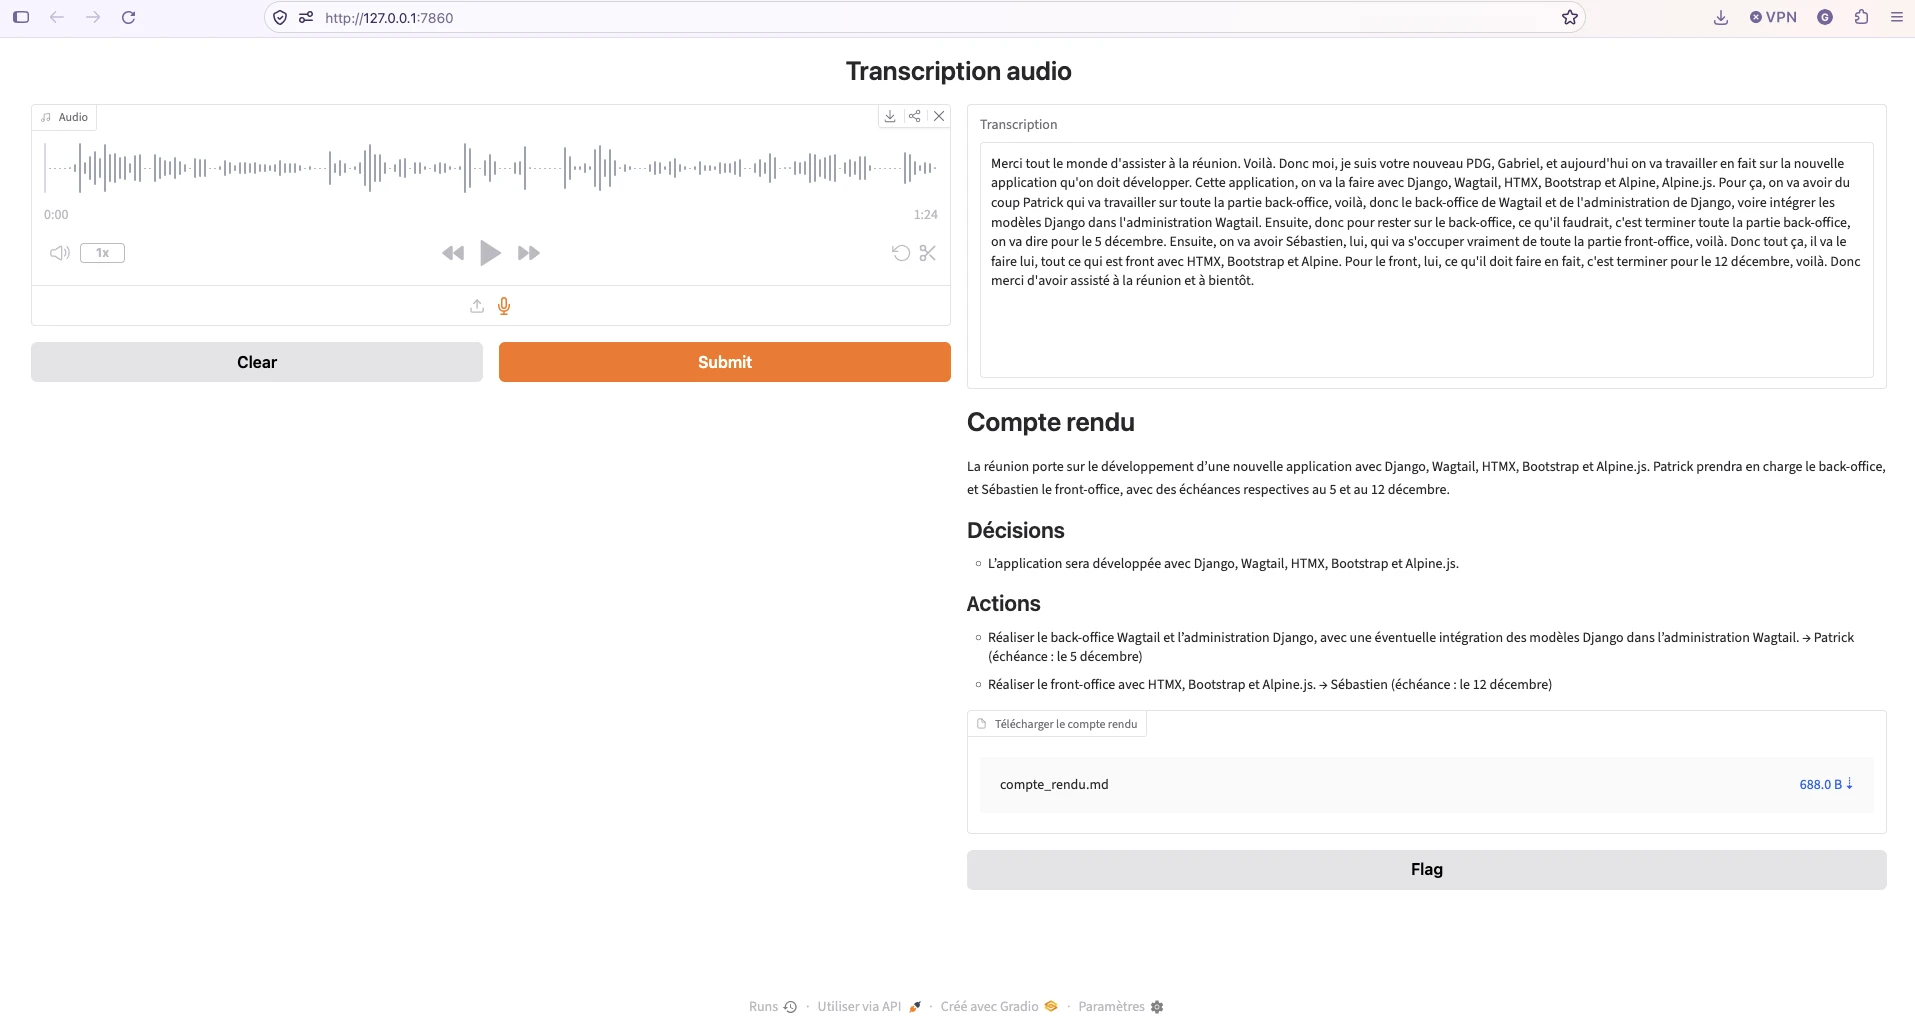
demo = gr.Interface(
    fn=traiter,
    inputs=gr.Audio(sources=["microphone", "upload"], type="filepath", label="Audio"),
    outputs=[
        gr.Textbox(label="Transcription"),
        gr.Markdown(label="Compte rendu"),
        gr.File(label="Télécharger le compte rendu"),
    ],
    title="Transcription audio",
)

if __name__ == "__main__":
    demo.launch()
La fonction traiter renvoie un tuple, et Gradio répartit les valeurs dans la sortie : la transcription, le compte rendu et le chemin du fichier à télécharger.
Lançons l'application :
uv run --env-file .env app.py
Je simule une réunion express 🤣.
Compte rendu
Comment savoir qui a parlé dans un audio ?
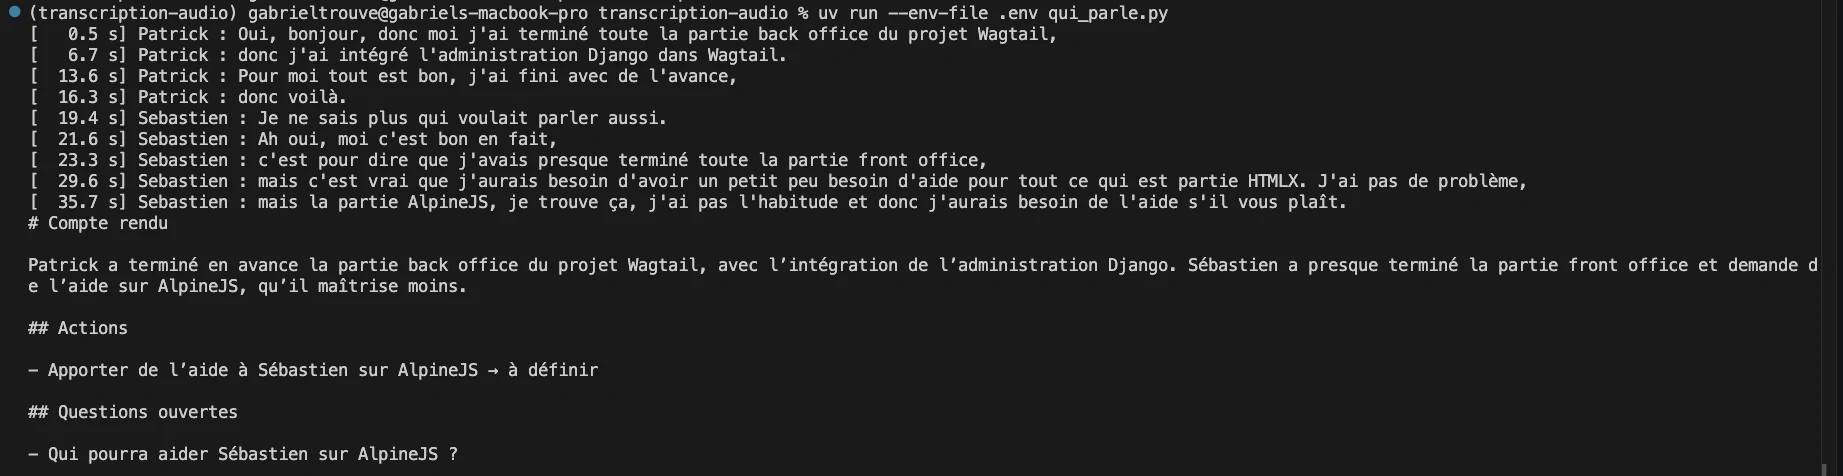
Pour ça, il nous faut la diarisation : découper l'audio selon les personnes qui s'expriment. OpenAI propose son propre modèle : gpt-4o-transcribe-diarize. Il renvoie la liste des segments avec les locuteurs, qui sont par défaut nommés A, B, C, etc.
À noter
Il est possible de nommer les participants en enregistrant un extrait avec la voix de chaque participant. Ce que nous allons faire ici ! Mais il faut savoir que chaque extrait doit durer entre deux et dix secondes et que l'on peut déclarer quatre personnes maximum.
J'ai enregistré un extrait WAV par personne dans un dossier voix, et simulé une réunion reunion.m4a.
J'ai créé un fichier qui_parle.py :
import base64
from pathlib import Path

from openai import OpenAI

from compte_rendu import en_markdown, rediger_compte_rendu

client = OpenAI()

# Un extrait WAV de 2 à 10 secondes par personne, 4 personnes au maximum
VOIX = {
    "Patrick": Path("voix/patrick.wav"),
    "Sebastien": Path("voix/sebastien.wav"),
}


def en_data_url(chemin: Path) -> str:
    """Encode un fichier WAV en data URL, le format attendu par l'API."""
    contenu = base64.b64encode(chemin.read_bytes()).decode("ascii")
    return f"data:audio/wav;base64,{contenu}"


def transcrire_avec_locuteurs(chemin: Path) -> str:
    """Transcrit un audio en indiquant qui parle à chaque segment."""
    with chemin.open("rb") as fichier_audio:
        transcription = client.audio.transcriptions.create(
            model="gpt-4o-transcribe-diarize",
            file=fichier_audio,
            response_format="diarized_json",
            # Obligatoire au-delà de 30 secondes d'audio
            chunking_strategy="auto",
            known_speaker_names=list(VOIX),
            known_speaker_references=[en_data_url(voix) for voix in VOIX.values()],
        )

    for segment in transcription.segments:
        print(f"[{segment.start:6.1f} s] {segment.speaker} : {segment.text.strip()}")

    return "\n".join(
        f"{segment.speaker} : {segment.text.strip()}"
        for segment in transcription.segments
    )


if __name__ == "__main__":
    texte = transcrire_avec_locuteurs(Path("reunion.m4a"))
    print(en_markdown(rediger_compte_rendu(texte)))
-
chunking_strategy="auto"est obligatoire si l'audio dépasse trente secondes -
known_speaker_namesetknown_speaker_referencesfonctionnent ensemble -
on réutilise
rediger_compte_rendu()
Diarisation
Vous pouvez, si vous le souhaitez, l'adapter pour l'utiliser avec Gradio.
import tempfile
from pathlib import Path

import gradio as gr

from compte_rendu import en_markdown, rediger_compte_rendu
from qui_parle import transcrire_avec_locuteurs


def traiter(chemin_audio: str | None) -> tuple[str, str, str]:
    """Transcrit l'audio avec les locuteurs, puis rédige le compte rendu."""
    if chemin_audio is None:
        raise gr.Error("Enregistrez ou déposez un fichier audio.")

    texte = transcrire_avec_locuteurs(Path(chemin_audio))
    markdown = en_markdown(rediger_compte_rendu(texte))
    chemin_md = Path(tempfile.mkdtemp()) / "compte_rendu.md"
    chemin_md.write_text(markdown, encoding="utf-8")
    return texte, markdown, str(chemin_md)


demo = gr.Interface(
    fn=traiter,
    inputs=gr.Audio(sources=["microphone", "upload"], type="filepath", label="Audio"),
    outputs=[
        gr.Textbox(label="Transcription"),
        gr.Markdown(label="Compte rendu"),
        gr.File(label="Télécharger le compte rendu"),
    ],
    title="Transcription audio",
)

if __name__ == "__main__":
    demo.launch()