La sortie de Python 3.15 est prévue pour le 1er octobre 2026, mais pas besoin d'attendre. La deuxième release candidate est disponible depuis quelques jours (1er septembre) et les fonctionnalités sont gelées, il est alors temps de s'intéresser aux nouvelles fonctionnalités qui arrivent avec cette dernière version.
Les imports paresseux
Certainement la plus grosse nouveauté de cette version : le lazy import.
Quand vous placez des imports en haut du fichier, chaque import est exécuté par Python dès qu'il le lit. Les modules sont donc chargés au démarrage, qu'ils soient utilisés ou non dans le script.
Avec un programme en ligne de commande où vous lancez plusieurs commandes, ce chargement peut commencer à se faire sentir. Je me suis amusé à lancer un interpréteur dans différentes conditions :
-
à vide démarre en 18 ms
-
avec
import requestsdémarre en 73 ms -
avec
import pandasdémarre en 211 ms
Voici le programme en question ci-dessous :
import subprocess
import sys
import time


def mesurer(code: str, repetitions: int = 5) -> float:
    """Retourne le meilleur temps (en ms) sur plusieurs lancements."""
    meilleur = float("inf")
    for _ in range(repetitions):
        debut = time.perf_counter()
        subprocess.run([sys.executable, "-c", code], check=True)
        meilleur = min(meilleur, time.perf_counter() - debut)
    return meilleur * 1000


cas = {
    "interpréteur vide": "pass",
    "import requests": "import requests",
    "import pandas": "import pandas",
}

for libelle, code in cas.items():
    print(f"{libelle:<24}{mesurer(code):>6.0f} ms")
La solution « classique » serait de déplacer l'import dans la fonction qui l'utilise : de cette manière, le module n'est chargé qu'au premier appel de la fonction. Personnellement, je n'aime pas faire ça, on disperse les imports un peu partout. La PEP 810 explique qu'environ 17 % des imports de la librairie standard sont placés dans des fonctions pour retarder leur exécution.
Python 3.15 permet d'utiliser le mot-clé lazy :
import sys

lazy import smtplib
lazy import csv

print("smtplib chargé ?", "smtplib" in sys.modules)
print("csv chargé ?", "csv" in sys.modules)


def exporter(lignes):
    with open("export.csv", "w", newline="", encoding="utf-8") as f:
        csv.writer(f).writerows(lignes)


exporter([["Patrick", "Lyon"], ["Sébastien", "Paris"]])

print("smtplib chargé ?", "smtplib" in sys.modules)
print("csv chargé ?", "csv" in sys.modules)

# Résultat :
# smtplib chargé ? False
# csv chargé ? False
# smtplib chargé ? False
# csv chargé ? True
Le lazy import ne charge rien, il utilise un proxy en attendant que le vrai chargement se fasse au premier accès. csv est bien utilisé dans la fonction, alors que smtplib ne l'est jamais.
On peut d'ailleurs afficher le proxy en passant par globals pour ne pas déclencher le chargement (méthode utilisée dans la PEP) :
lazy import smtplib

print(globals()["smtplib"])

smtplib.SMTP

print(globals()["smtplib"])

# <lazy_import 'smtplib'>
# <module 'smtplib' from '/Users/gabrieltrouve/.local/share/uv/python/cpython-3.15.0rc2-macos-aarch64-none/lib/python3.15/smtplib.py'>
Attention
Si le module n'existe pas, l'erreur n'est levée qu'à la première utilisation, avec des tracebacks qui pointent les deux endroits :
lazy import module_inexistant

print("Le script démarre sans problème")

module_inexistant.faire_un_truc()

"""
Le script démarre sans problème
Traceback (most recent call last):
  File "/Users/gabrieltrouve/Pro/py315/main.py", line 1, in <module>
    lazy import module_inexistant
ImportError: lazy import of 'module_inexistant' raised an exception during resolution

The above exception was the direct cause of the following exception:

Traceback (most recent call last):
  File "/Users/gabrieltrouve/Pro/py315/main.py", line 5, in <module>
    module_inexistant.faire_un_truc()
    ^^^^^^^^^^^^^^^^^
ModuleNotFoundError: No module named 'module_inexistant'
"""
À noter
Les imports circulaires ne disparaissent pas totalement. Si l'un des deux modules utilise l'autre au niveau du module, l'erreur revient. La PEP précise elle-même qu'il faut éviter les imports circulaires. De plus, lazy n'est autorisé qu'au niveau du module.
Le dictionnaire immuable frozendict
Vous connaissez le frozenset ? Sinon, n'hésitez pas à aller lire notre glossaire sur les ensembles. Python 3.15 ajoute le type natif frozendict :
DATA = frozendict({"nom": "patrick", "age": 30})

print(DATA["nom"])  # Affiche : patrick
print(DATA["age"])  # Affiche : 30

DATA["nom"] = "sebastien"
# TypeError: 'frozendict' object does not support item assignment
Comme il est immuable, il est hashable tant que ses clés et ses valeurs le sont. Il est alors possible d'utiliser un frozendict en clé de dictionnaire ou dans un ensemble :
tarifs = {
    frozendict(zone="France", poids="lourd"): 12.5,
    frozendict(zone="Europe", poids="lourd"): 19.9,
}

print(tarifs[frozendict(zone="France", poids="lourd")])  # Affiche : 12.5
Attention
frozendict n'hérite pas de dict, il s'agit d'un type natif, tout comme dict.
DATA = frozendict({"nom": "patrick", "age": 30})


print(isinstance(DATA, dict)) # False
Pour avoir une version modifiable d'un frozendict, vous pouvez toujours le convertir en dictionnaire avec dict(DATA) qui en fera une copie, et l'opérateur | renverra un nouveau frozendict.
DATA = frozendict({"nom": "patrick", "age": 30})


NEW_DATA = DATA | {"ville": "Ons en Bray"}

print(type(NEW_DATA))  # <class 'frozendict'>
Savoir si un argument a été fourni avec sentinel
Imaginons que Patrick mette à jour les numéros de téléphone de ses clients :
-
l'effacer
-
ne pas y toucher
-
le modifier
Nous avons 3 cas, mais avec None par défaut nous n'en distinguons que deux :
def modifier_client(client, telephone=None):
    if telephone is None:
        return  # Ne pas toucher au numéro ou l'effacer ?
    client["telephone"] = telephone
modifier_client(sebastien) et modifier_client(sebastien, telephone=None) donnent None à la fonction. Patrick n'a-t-il rien précisé ou a-t-il effacé le numéro ?
Aujourd'hui, la documentation officielle utilise un objet unique que personne ne passe par accident comme valeur par défaut :
_NON_FOURNI = object()


def modifier_client(client, telephone=_NON_FOURNI):
    if telephone is _NON_FOURNI:
        return  # L'argument n'a pas été fourni, on ne touche à rien
    client["telephone"] = telephone  # None, pour effacer


sebastien = {"nom": "sebastien", "telephone": "04 72 00 00 00"}

modifier_client(sebastien)
print(sebastien["telephone"])  # Résultat : 04 72 00 00 00

modifier_client(sebastien, telephone=None)
print(sebastien["telephone"])  # Résultat : None
Cependant, la valeur par défaut de l'objet _NON_FOURNI affiche l'adresse mémoire <object object at 0x...> et ne se type pas proprement, car il est de type object, la classe mère de tout ce qui existe en Python.
Python 3.15 intervient en ajoutant sentinel, en reprenant la même idée, mais cette fois l'objet a un nom :
NON_FOURNI = sentinel("NON_FOURNI")


def modifier_client(client: dict, telephone: str | None | NON_FOURNI = NON_FOURNI) -> None:
    if telephone is NON_FOURNI:
        return
    client["telephone"] = telephone


print(NON_FOURNI)  # Résultat : NON_FOURNI
Le nom s'affiche tel quel, et la sentinelle s'utilise directement dans l'annotation.
L'unpacking dans les compréhensions
Jusqu'à aujourd'hui, on ne pouvait pas utiliser l'opérateur * pour déballer une liste dans une compréhension. Il fallait utiliser le double for ou itertools :
import itertools

equipes = [["Patrick", "Ely"], ["Sébastien"], ["Mélanie", "Ana", "Geneviève"]]

print([nom for equipe in equipes for nom in equipe])
print(list(itertools.chain.from_iterable(equipes)))
Inscrivez-vous gratuitement pour modifier et exécuter du code Python directement dans votre navigateur.
Avec Python 3.15 :
equipes = [["Patrick", "Ely"], ["Sébastien"], ["Mélanie", "Ana", "Geneviève"]]

print([*equipe for equipe in equipes])
# ['Patrick', 'Ely', 'Sébastien', 'Mélanie', 'Ana', 'Geneviève']
Ce que je trouve bien plus lisible personnellement. Et ça fonctionne aussi avec les dictionnaires :
defauts = {"nom": "patrick", "age": "60"}
utilisateur = {"ville": "Ons en Bray"}

print({**d for d in [defauts, utilisateur]})
# Affiche : {'nom': 'patrick', 'age': '60', 'ville': 'Ons en Bray'}
UTF-8 par défaut
Avec la PEP 686, l'encodage par défaut devient l'UTF-8. Car sans argument, Python utilisait l'encodage système jusqu'ici.
À noter
Si UTF-8 est utilisé sur Mac et Linux, on retrouve souvent le cp1252 sur Windows.
Attention
Ce changement ne concerne que les appels sans argument encoding : continuez à passer cet argument tant que votre code tourne sur des versions antérieures.
Le profiler Tachyon
Ajouté par la PEP 799, Tachyon est un profiler statistique qui permet d'analyser ce qui prend le plus de temps dans un script.
Prenons un exemple :
import time


def charger_donnees():
    time.sleep(0.4)  # Simule une lecture en base
    return list(range(200_000))


def calculer_tva(montants):
    return [m * 1.2 for m in montants]


def generer_rapport():
    montants = charger_donnees()
    for _ in range(20):
        calculer_tva(montants)


generer_rapport()
Lançons-le avec le profiler : python -m profiling.sampling run main.py. Comme Tachyon lit la mémoire du processus, il faut des droits particuliers. Sur mon Mac, je suis passé par sudo "$(which python)" -m profiling.sampling run main.py.
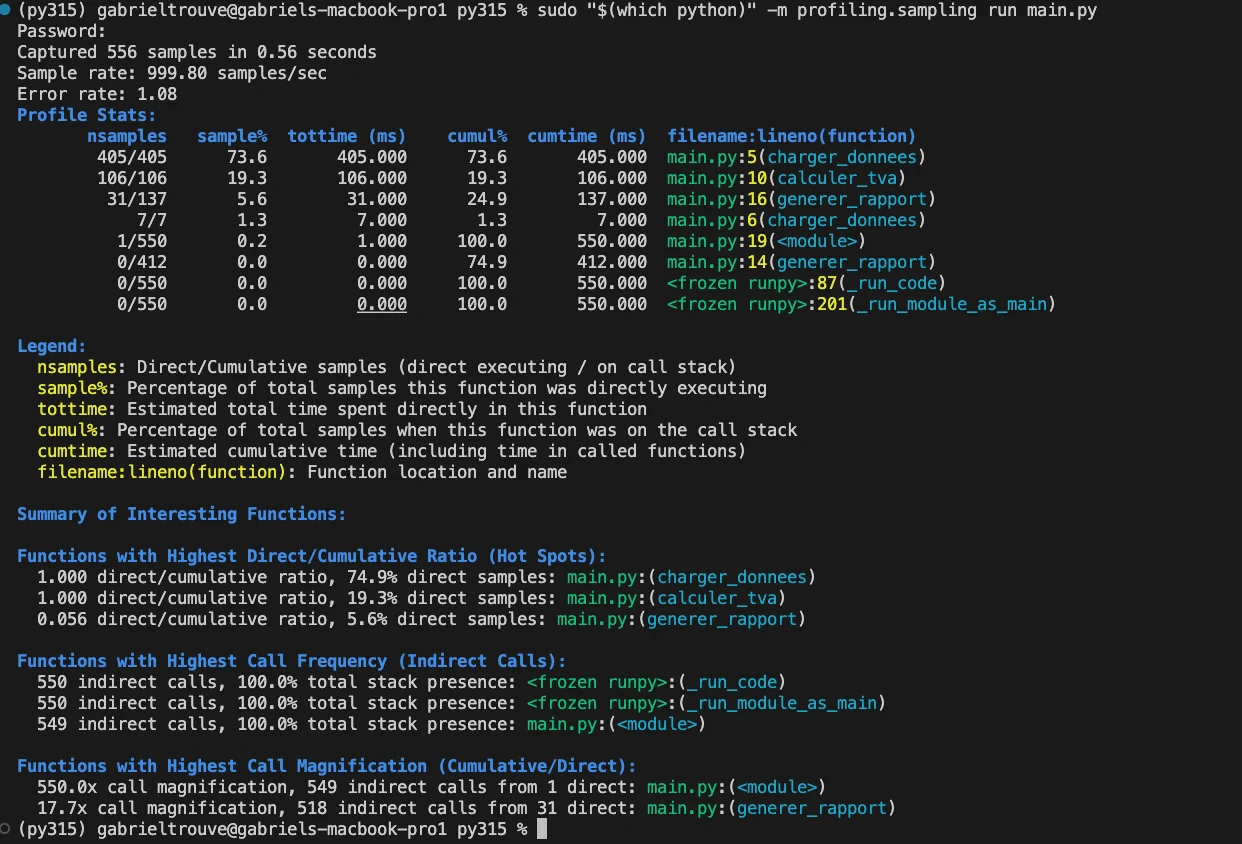
Résultat du profiler
Il est même possible de générer un rapport au format HTML avec sudo "$(which python)" -m profiling.sampling run --flamegraph -o rapport.html main.py.
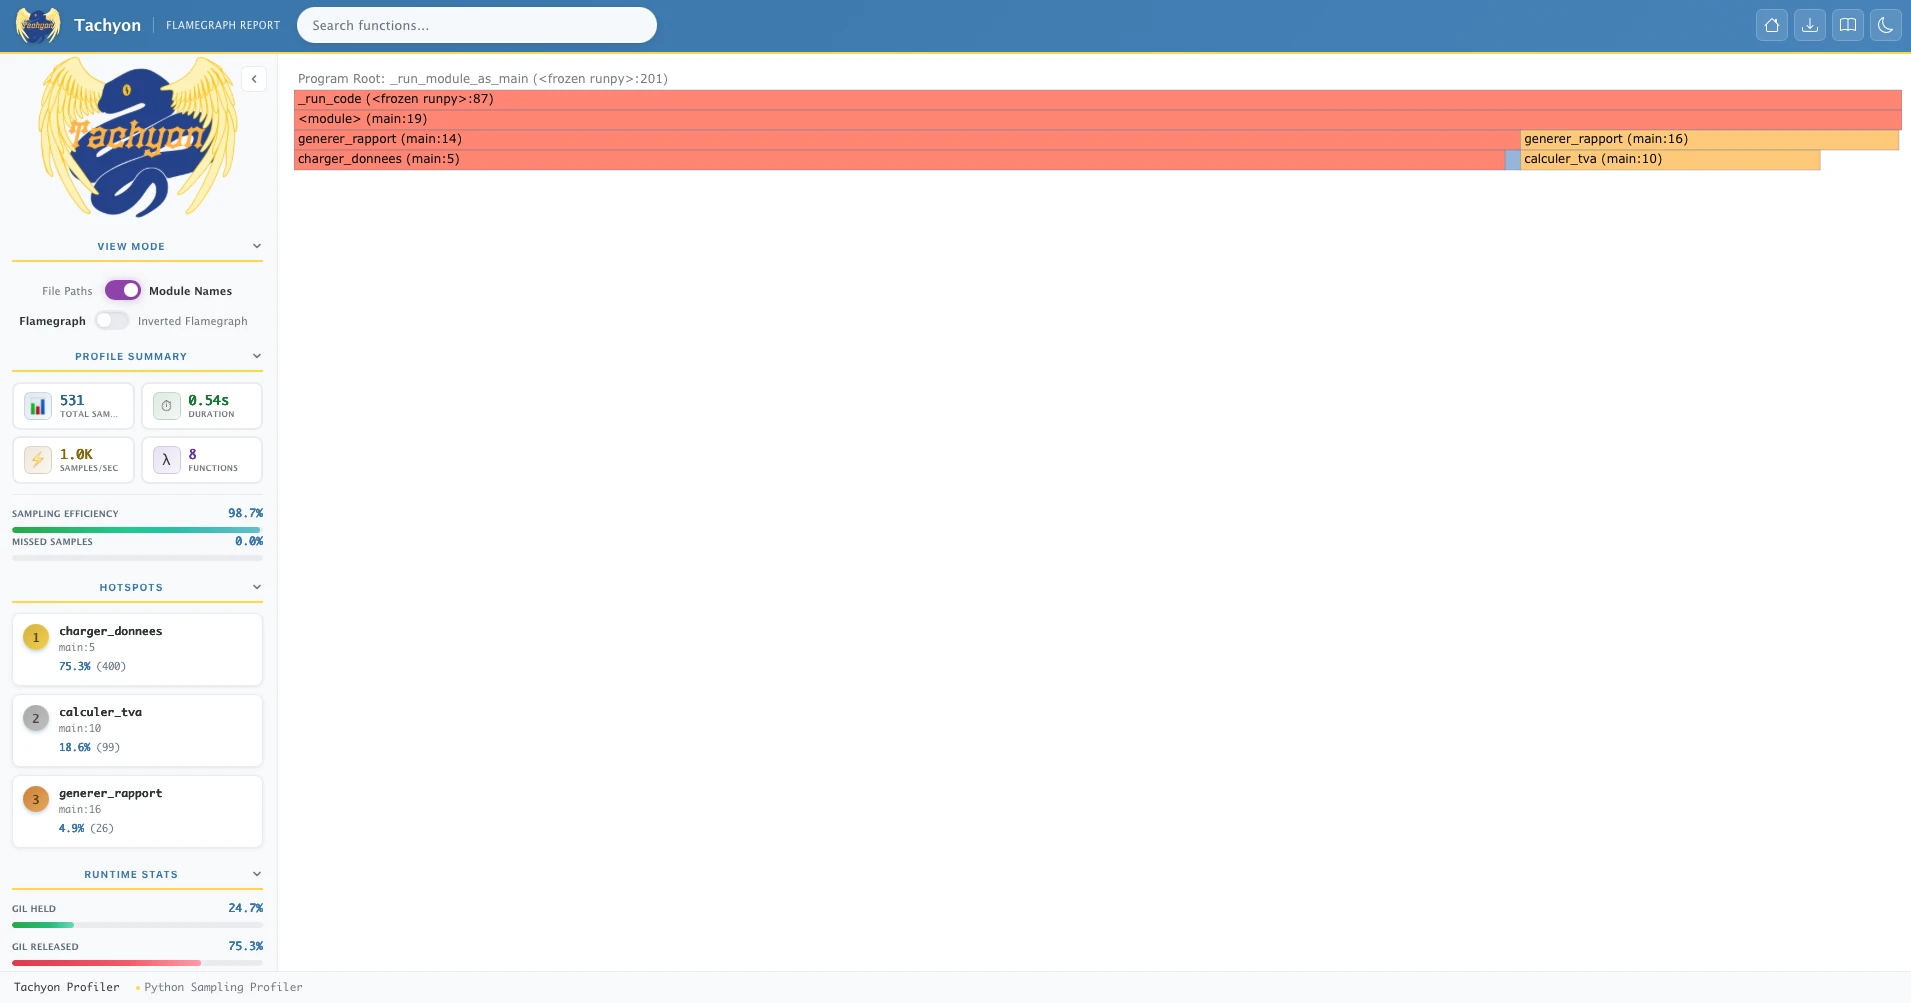
Flame graph généré par Tachyon
Les messages des AttributeError
Python 3.14 nous simplifiait la vie avec ses messages d'erreur. Python 3.15 simplifie la vie aux personnes venant d'un autre langage en s'attaquant aux AttributeError.
L'interpréteur possède maintenant une table des méthodes les plus courantes des autres langages pour proposer une équivalence en Python :
[1, 2, 3].push(4)
# AttributeError: 'list' object has no attribute 'push'. Did you mean '.append'?

"patrick".toUpperCase()
# AttributeError: 'str' object has no attribute 'toUpperCase'. Did you mean '.upper'?

{}.put("cle", 1)
# AttributeError: 'dict' object has no attribute 'put'. Use d[k] = v.
Même principe si vous confondez un tuple et une liste :
(1, 2, 3).append(4)
# AttributeError: 'tuple' object has no attribute 'append'. Did you mean to use a 'list' object?
Pour vos propres classes, Python regarde si l'attribut demandé existe sur l'un des attributs de votre objet :
from dataclasses import dataclass


@dataclass
class Facture:
    montant: float

    @property
    def ttc(self) -> float:
        return self.montant * 1.2


class Dossier:
    def __init__(self, facture: Facture) -> None:
        self.facture = facture


dossier = Dossier(Facture(montant=100.0))
print(dossier.ttc)
# AttributeError: 'Dossier' object has no attribute 'ttc'. Did you mean '.facture.ttc' instead of '.ttc'?
Ça ne s'arrête pas là, je ne cite pas toutes les modifications et tous les ajouts (vous comprendrez 😅). Mais n'hésitez pas à lire la release note de cette nouvelle version pour découvrir toutes les nouveautés.