SWE-bench Verified, GPQA Diamond et j'en passe. À chaque nouveau modèle, c'est la même avalanche de chiffres. Les premières fois où j'ai regardé les benchmarks, j'étais dans le flou total. Je regardais le pourcentage le plus élevé et je me disais : « Je pense que ça doit être bien si le chiffre est le plus élevé ».
Sur Docstring, nous vous avons écrit un article pour démystifier le sujet.
C'est quoi un benchmark ?
Un benchmark est un test standardisé, une épreuve commune avec une liste figée de questions ou de tâches, tout comme la façon de noter. La même épreuve est soumise à chaque modèle. C'est une manière fiable de comparer les modèles.
Concrètement, pourquoi les benchmarks existent ?
-
Mesurer le progrès d'une année sur l'autre
-
Comparer les modèles entre eux
-
Communiquer (je pense en effet qu'il y a un petit côté marketing parfois)
Comment fonctionne un benchmark ?
Un benchmark est composé de trois éléments.
Le jeu de données
Il s'agit d'une liste de questions ou de tâches avec chacune la réponse attendue. Prenez MMLU (Massive Multitask Language Understanding), l'un des benchmarks sur la culture générale les plus cités. Voici le format d'une question :
How many numbers are in the list 25, 26, ..., 100?
(A) 75  (B) 76  (C) 22  (D) 23
Answer: B
La métrique
Concrètement, on répond à la question : comment on note ? La méthode la plus répandue est la correspondance exacte. La réponse est bonne ou ne l'est pas.
Pour le code, la réponse est utilisée et les tests permettent de juger de la qualité.
Concernant les arènes, on pose la même question à deux modèles dont on cache le nom ; plusieurs personnes vont choisir la réponse qu'elles préfèrent.
Le protocole
Comment on fait passer l'examen ? Avec un mode de réflexion ? Avec quels outils ? Sur toutes les questions ? Combien de tentatives ?
C'est ici que ça se complique un peu. Si vous prenez le SWE-bench Verified, la référence pour le code, il contient 500 tâches, mais... Regardons qui l'évaluait sur combien de tâches à l'été 2025 :
-
OpenAI utilise un sous-ensemble de 477 tâches pour GPT-5, car les 23 autres ne tournaient pas de manière fiable sur leur infrastructure
-
Anthropic, pour Claude 4, utilise l'ensemble complet de 500 tâches
-
Epoch AI, un institut indépendant qui refait les benchmarks lui-même, en utilise 484
Trois périmètres différents pour un même benchmark.
En février 2026, Epoch a changé son harnais pour l'évaluation, ce qui a permis une amélioration des scores avec un même modèle. Comme quoi, le harnais en IA n'est pas un détail, et on en parle dans cet article.
Les grandes familles de benchmarks
Voici les familles que vous croiserez le plus souvent :
-
Connaissances générales : Comme le MMLU et le MMLU-Pro
-
Sciences (niveau doctorat) : Le GPQA en fait partie, il porte sur des questions de biologie, physique et chimie
-
Niveau expert, toutes disciplines confondues : Le Humanity's Last Exam comprend 2 500 questions de maths, de sciences et de sciences humaines
-
Code : Historiquement, vous trouverez le HumanEval, et surtout le SWE-bench Verified qui est évalué sur des issues GitHub
-
Agents : OSWorld, un benchmark sur des tâches réalisées sur un vrai ordinateur, ou encore le Terminal-Bench pour les tâches en ligne de commande
-
Résolution du jamais-vu : ARC-AGI, où l'IA doit comprendre seule ce que l'on attend d'elle
-
Préférence humaine : Prenons l'exemple de l'Arena, où les utilisateurs comparent à l'aveugle les réponses et votent
-
Durée des tâches : Le benchmark de METR permet de mesurer la longueur des tâches qu'un modèle accomplit
Où trouver les scores ?
Les éditeurs publient eux-mêmes les scores à chaque sortie d'un de leurs nouveaux modèles. Les scores sont « auto-déclarés ». L'AI Index de Stanford, qui compile ces scores, part du principe que les résultats déclarés par les entreprises comme OpenAI et Anthropic sont exacts. L'AI Index note aussi que des évaluations tierces ont documenté des cas où les modèles font moins bien en test indépendant.
Aussi, quelques organisations font les benchmarks elles-mêmes de manière indépendante comme Epoch, swebench.com, arcprize.org, ou lastexam.ai.
Pourquoi les benchmarks sont critiqués
La saturation
Un benchmark permet de départager des modèles. Mais quand tous les modèles atteignent 90 %, ils ne mesurent plus rien. C'est ce qui est arrivé au MMLU, et c'est pour cette raison que Humanity's Last Exam a été créé. Ce qu'il faut se dire, c'est que sur un benchmark saturé, un écart d'un ou deux points ne vaut plus rien.
La contamination
Les modèles sont en grande partie entraînés sur le web. En fait, comme les benchmarks sont publiés sur GitHub, Hugging Face ou discutés sur des forums, c'est comme si le sujet du bac finissait dans les fichiers de révision. C'est pour cette raison qu'une des parades est de renouveler les questions.
Ils peuvent contenir des erreurs
L'erreur est humaine, et comme les benchmarks sont créés par des humains, ils peuvent contenir eux-mêmes des erreurs. Par exemple, une équipe avait trouvé que 6,49 % des questions pour le MMLU contenaient des erreurs.
Du côté de Humanity's Last Exam, il faut croire qu'il y a eu quelques problèmes aussi sur environ 30 % des réponses en chimie et en bilogie.
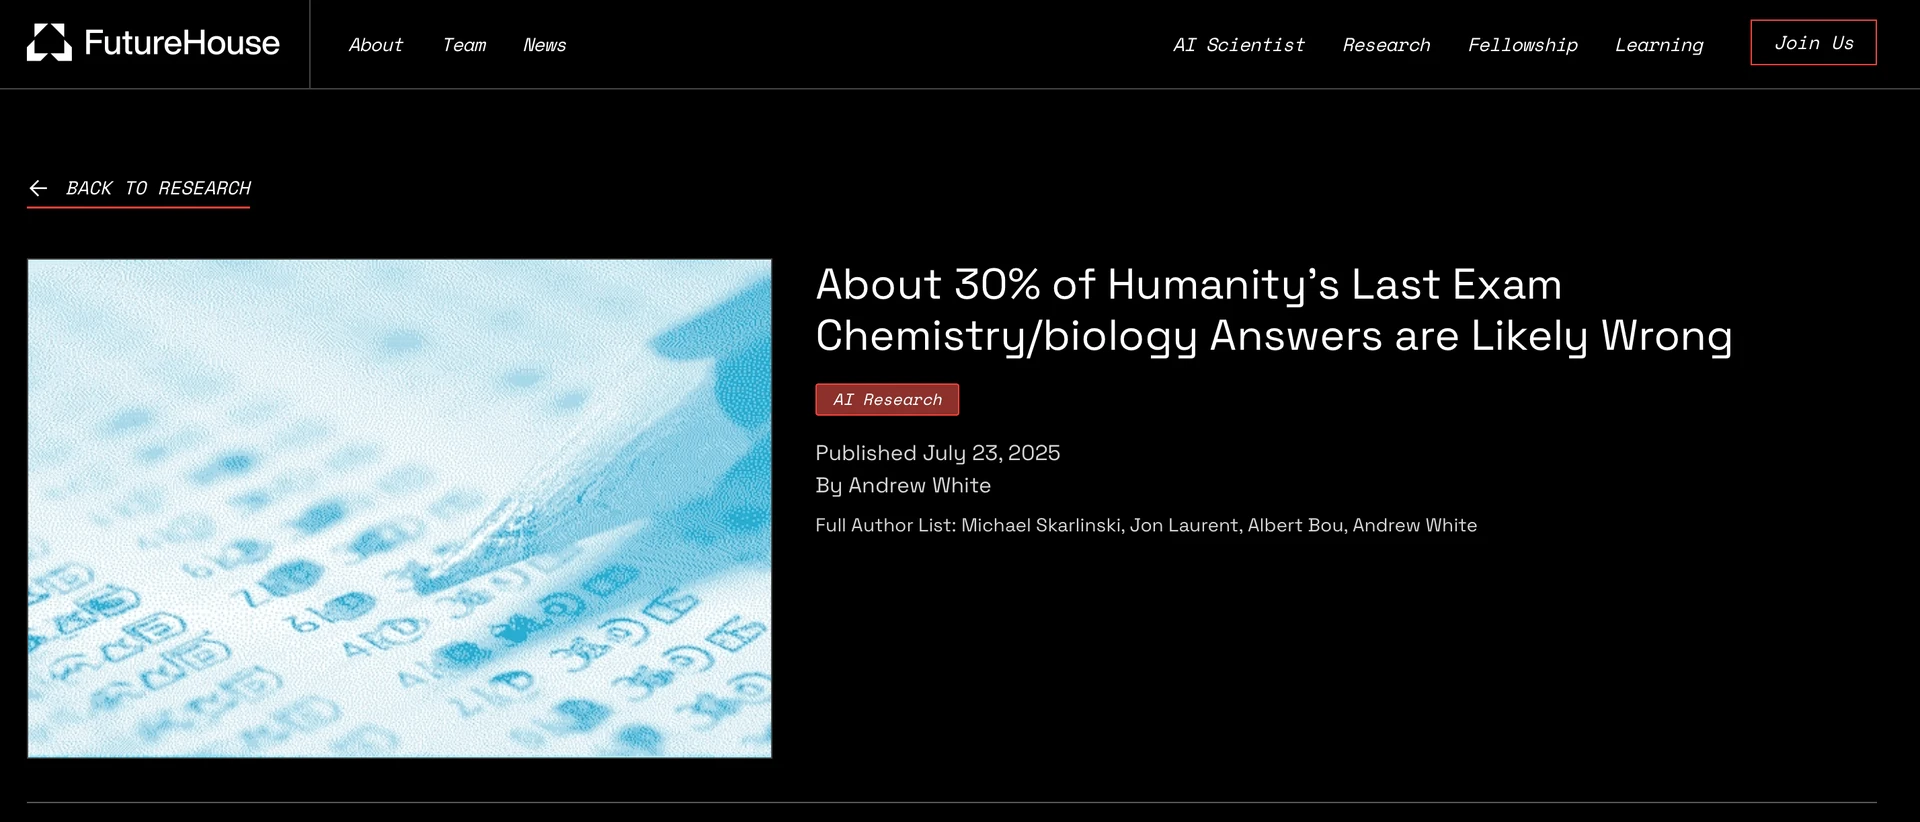
Extrait de FutureHouse : https://www.futurehouse.org/research/hle-exam
Quand une mesure devient un objectif, elle cesse d'être une bonne mesure
Vous connaissez peut-être la loi de Goodhart :
Any observed statistical regularity will tend to collapse once pressure is placed upon it for control purposes.
La formulation la plus connue est celle du titre. Elle est de Marilyn Strathern qui résume bien celle de Goodhart.
Un exemple documenté : un papier concerne l'Arena et montre que certains éditeurs pouvaient tester en privé de nombreuses variantes d'un modèle et ne publier que le meilleur score.
Vous l'aurez compris, demandez-vous qui a mesuré 😉.
Les benchmarks sont évidemment essentiels pour mesurer la capacité d'un modèle. Mais ce que je recommande en plus d'un bon modèle, c'est de bien définir son harnais, et si vous utilisez l'IA pour coder, apprenez au moins un langage et un framework.